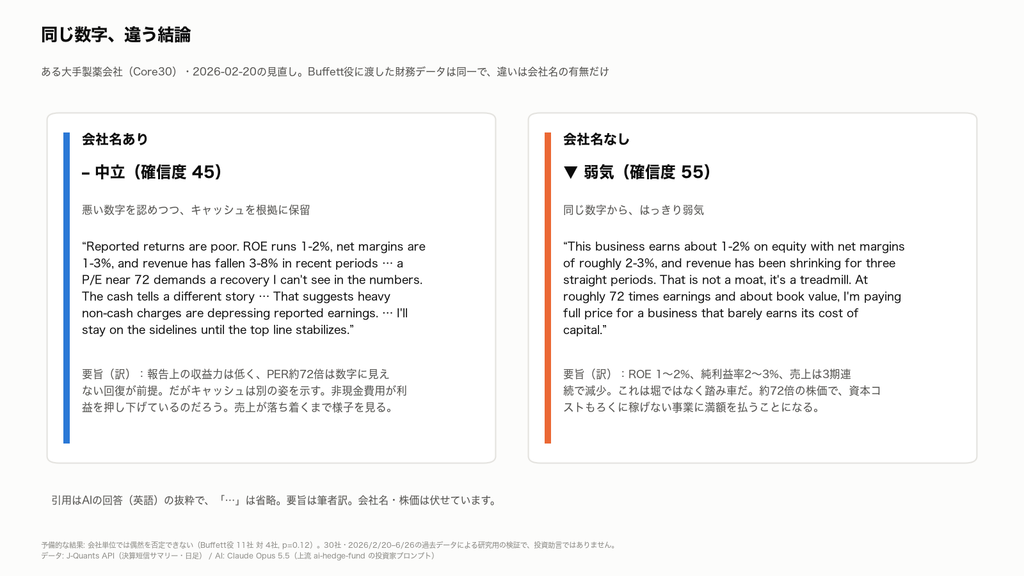
ある大手製薬会社のデータです。ROEは1〜2%、PERは約72倍、売上は減少しています。会社名を伏せてAIに情報を渡したところ、AIは「これはMoat(競争優位)ではなく、踏み車だ」と書き、弱気と判断しました。今後は会社名がわかる形で渡すと、「キャッシュは別の姿を示している」と書いて判断を保留し、中立にしました。
数字は一字一句同じです。変わったのは、AIが「どの会社か」を知っていたかどうかだけでした。
投資家やアナリストがAIに決算を読ませる場面は、すでに珍しくありません。というかもうほとんどがAIを使っているでしょう。そのときAIは、本当に御社が開示した資料だけを根拠に判断しているのでしょうか?
AIが開示を読むなら、IRの仕事は「正しく開示する」ことに加えて、「開示した内容が、AIに正しく読み取られているか」まで広がります。今回の私の実践は、その読み取りが資料の外にある「会社のイメージ」に左右されうることを示唆しています。
記事の要点
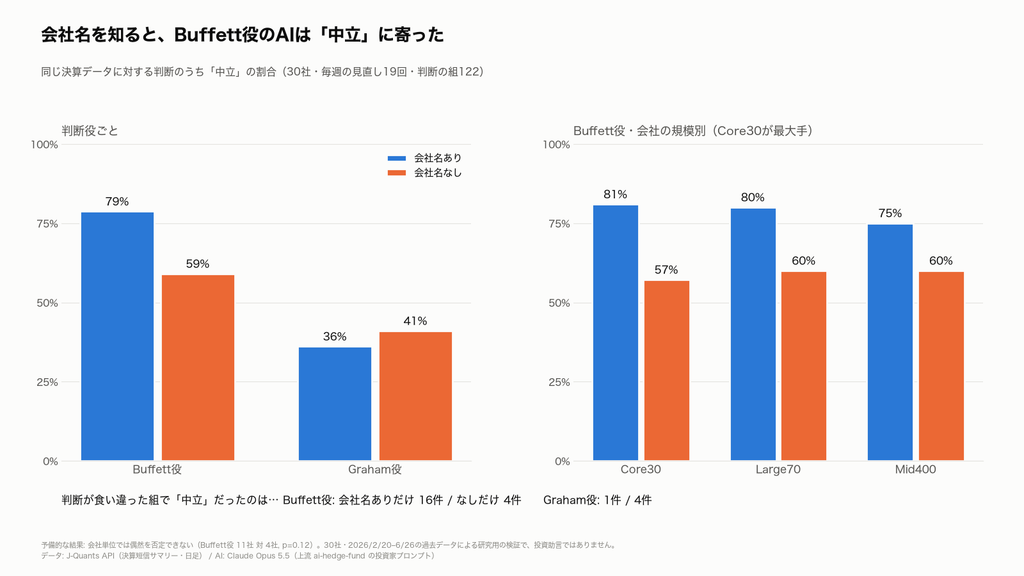
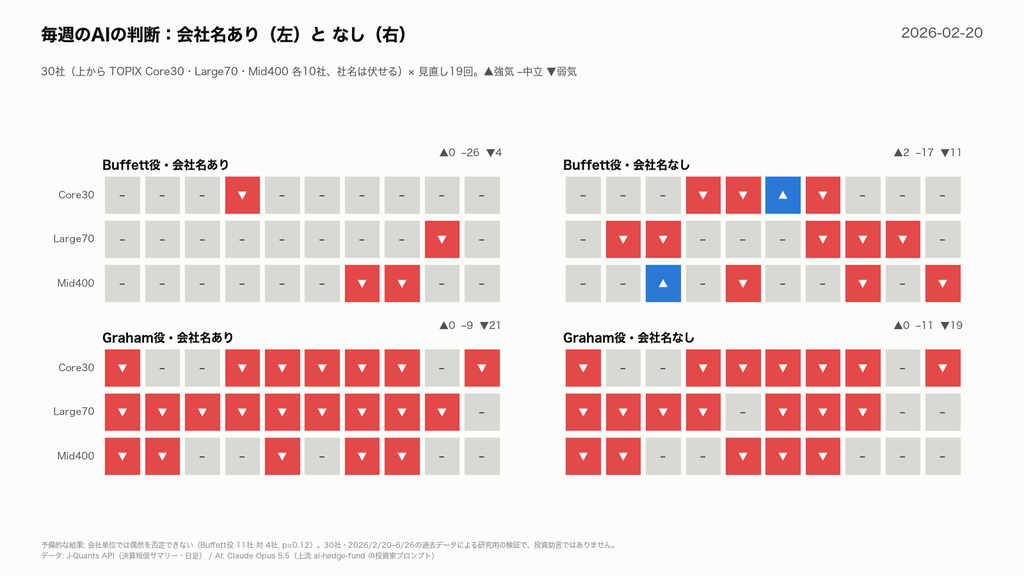
- 会社名がわかると、AIは弱気を控えることがあった。長期の事業の質を重視する役を与えたAIでは、「中立」の割合が59%から79%に増えた。
- AIは渡していない知識を判断理由に持ち込む。会社がわかる条件では、資料に書かれていない事業の説明が10社中8社の回答に現れた。
- ただし、まだ予備的な結果。会社単位で見ると偶然の可能性を否定できない(p = 0.12)。「IRを増やせばAIが甘くなる」と示したものではない。しかし、示唆は大きい。
実践したこと
こんにちは。齊藤です。私は個人の研究としても、AIの判断を売買シミュレーションにつなげる「Agentic Trading」を勉強・実践しています。
そして今回使ったのは、米国株向けのオープンソース「ai-hedge-fund」です。これは、ヘッジファンドの組織をAIとプログラムで再現する教育・研究用のプロジェクトのようです。
- アナリスト: Warren Buffett、Benjamin Graham などの投資家の考え方をまねたLLMエージェントや、数式モデル。銘柄ごとに「強気/中立/弱気」と確信度を返す
- ポートフォリオ構築: 判断を目標の比率に直す
- リスク管理: 1銘柄の上限などで比率を抑える
- 売買と記録: 仮想の証券会社で約定させ、判断の理由まで含めて記録する
同じ仕組みを過去の日付で繰り返すとバックテストになります。上流は「その時点で公開済みのデータしか使わない(先読みしない)」を最重要の原則にしていて、財務データは提出日で絞り込んでいることがコードから確認できます。
このOSSはもともと米国株を前提に作られています。私はこれを日本株でも動かしてみたくなったので、日本株の株価データ・決算データを取得できるJ-Quantsや、東証の100株単位の売買に対応させるなど、日本株対応にカスタマイズをしています(現在進行形で進めているのでぜひ手伝ってください: https://github.com/TIshow/ai-hedge-fund-jp )。また、今のところは実際の注文は一切出していません。
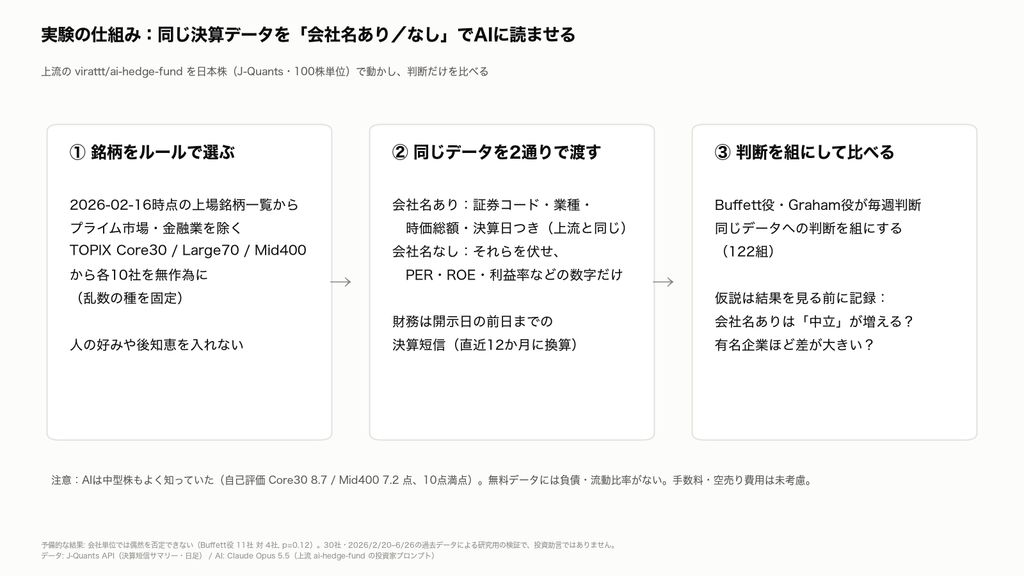
実験の設計は次のとおりです。
| 項目 | 内容 |
|---|---|
| 対象 | TOPIX Core30・Large70・Mid400から、金融業を除いて各10社、計30社。事前に決めたルールで無作為に選定 |
| 期間 | 2026年2月〜6月の19週。各時点で、その前日までに公表された決算短信のデータだけをAIに渡す |
| 条件A:AIが会社名がわかる | 証券コード・業種・時価総額・決算日つきで渡す |
| 条件B:AIには会社名がわかりにくい | 社名・証券コード・業種・時価総額などを伏せ、決算期も「直近」「3か月前」といった表記にする。財務指標の数値はAと同じ |
| AIの役 | 事業の質や長期の見通しを重視する「Buffett役」と、価格や財務の安全性を厳しく見る「Graham役」。実在の二人の判断を再現したものではなく、判断基準を変えるための設定 |
| 比較の単位 | 同じ決算データに対する両条件の判断を組にして比較(二つの役の合計で122組) |
仮説は、結果を見る前に手順書へ記録しておきました。
結果1:Buffett役のAIは、会社名がわかると「弱気を控えた」
| AIの役 | 会社がわかる場合の「中立」 | わかりにくくした場合の「中立」 | 両条件で判断が一致した割合 |
|---|---|---|---|
| Buffett役 | 79% | 59% | 67% |
| Graham役 | 36% | 41% | 92% |
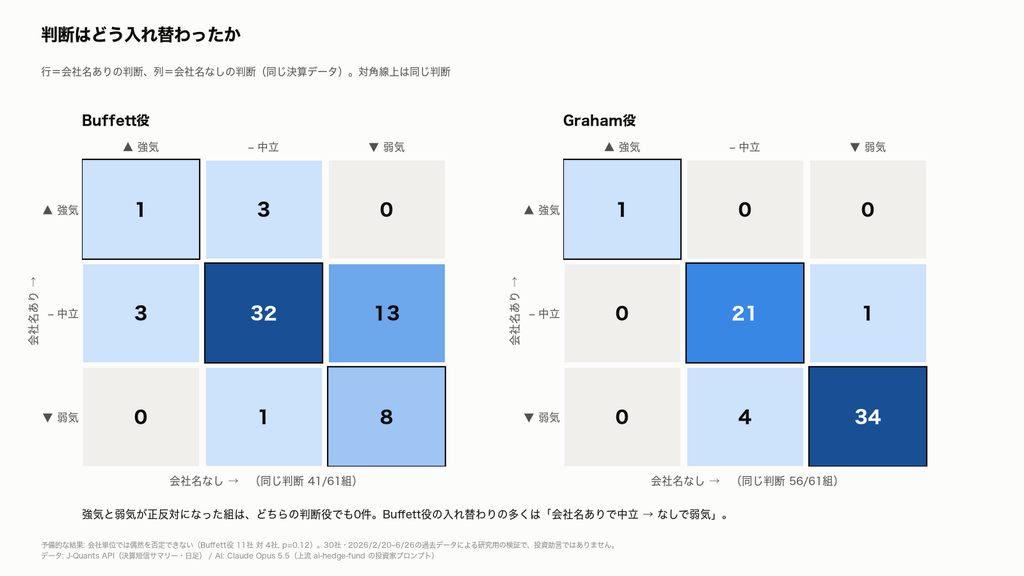
Buffett役で、中立かどうかの判断が二つの条件で食い違ったのは20組。そのうち16組は「会社がわかる場合だけ中立」でした。さらにその13組では、会社をわかりにくくすると評価が「弱気」に変わっています。強気と弱気が正反対に入れ替わった組はありませんでした。
つまり、会社のことを知っているAIは「悪い数字を見ても、弱気と言い切らずに保留する」方向に動いていたということになります。冒頭の製薬会社の例は、その典型です。
一方、Graham役は92%の組で会社がわかる場合とそうでない場合での判断が一致し、ほぼ会社を知っているかどうかの影響を受けませんでした。会社の情報を見せることの影響は、AIに何を重視させるかによって変わる可能性があるようです。
「会社のことを知っているAI」とはどういうことかというと、たとえば2026年2月の投資判断を再現するとき(バックテスト)、プログラムには2月時点で公表済みの決算だけを渡せます。AIにも「その後の出来事は使わないで」と指示できますし、本OSSでもその設定になっています。しかし、いま呼び出しているAIが、2月以降の情報を学習済みである可能性までは消せません。もし未来の情報が判断に混ざれば、過去の売買計算は動いても、「当時の情報だけを使った判断に予測力があったか」は確かめられません。
結果2:会社を知っているAIは、資料の外から情報を持ち込む
トヨタの財務データを読ませたところ、AIは渡した資料にない「車を作る会社」という知識を使い、キャッシュフローの振れを金融子会社の影響だと説明しました。金融事業についての情報は入力していません。
これはトヨタだけの話ではありませんでした。30社の実験に先立って手で選んだ10社でも、会社がわかる条件では、入力した財務データに書かれていない事業の説明が8社の回答に現れました。会社をわかりにくくした条件では、該当する回答はありませんでした。
会社を知っていることは、数字の背景を理解する助けにもなります。しかし、その説明が古い情報に基づいていたり、今回の開示資料では確認できない内容だったりするかもしれません。AIが流暢に説明できることと、その説明の根拠を確かめられることは別です。
結果3:情報を伏せすぎると、今度は誤解が起きる
逆の問題もありました。業種まで伏せると、AIが化学メーカーを「金融系」と推測するなど、事業を取り違えた例が出ました。
会社を特定できる情報は、判断を偏らせる可能性もあれば、理解を助ける可能性もあります。だからこそ、AIの結論だけでなく、回答の中身と根拠を見て確かめる必要があります。
冷静に:この結果から、どこまで言えるか
目をひく結果ほど、限界をはっきりさせておきたいと思います。
- 統計的にはまだ弱い。同じ会社への複数回の判断を別々に数えると、結果が実際より確かに見えます。会社ごとにまとめると、会社がわかる場合に中立が多かったのは11社、少なかったのは4社、差がないのは15社。偶然の可能性を否定できない水準です(会社単位の検定で p = 0.12)。
- 伏せたのは会社名だけではない。証券コード・業種・時価総額・日付をまとめて伏せたため、「会社名だけが原因」とは言えません。残した数値から会社を推測できる余地もあります。
- 「有名企業と無名企業」を直接比べたわけではない。比べたのは、同じ会社について識別できる情報の有無です。規模別では、Buffett役の中立の差はCore30で24ポイント、Large70で20ポイント、Mid400で15ポイントと仮説どおりの向きでしたが、差の差は数件分にすぎません。
- 規模は小さい。30社・約4か月半・AIモデル1種類による予備的な検証です。有利子負債や流動比率など、一部の判断に必要な項目もデータに含まれていません。
- IRの量や質は測っていない。IRの発信量や、資料の機械可読性は調べていません。「IRを増やせばAIが甘く評価する」と示した結果ではありません。
今回言えるのは、同じ財務数値でも、企業を特定しやすいかどうかでAIの評価が変わることがあり、その変わり方は判断基準によって違いそうだ、というところまでです。IR担当者が、今日から試せる3つの点検
今回の結果を受けて、私がIRの現場で確かめたいことを3つにまとめました。いずれも効果を実証した施策ではなく、これから点検したい項目です。お手元のAIでも試せます。
点検1:AIは自社を「開示どおり」に説明できるか
自社の統合報告書や決算説明資料などの公開資料を指定し、事業内容と主要なリスクを説明させます。そのうえで、どの資料のどの記述を根拠にしたのかを示させてください。
- 資料にない説明が混ざっていないか
- 事業再編の前の、古い事業構成のまま説明していないか
試す際の問いかけ例:「添付した資料だけを根拠に、この会社の事業セグメントと主要なリスクを説明してください。各説明について、根拠にした資料名とページを示し、資料に書かれていない内容は“資料外”と明記してください。」
点検2:数字の「意味」まで伝わるか
指標の定義、単位、対象期間は明確でしょうか。事業の再編などで前年と比較する条件が変わった場合、その変化をAIが読み取れるか試してください。今回の実験でも、事業を分離した会社では今期と前年で数字の範囲が異なり、データからは補正できないケースがありました。
点検3:会社の「印象」が、資料の読み方を変えていないか
同じ財務数値を、会社がわかる形とわからない形で読ませ、説明の根拠や判断を比べます。会社名だけの影響を知りたい場合は、業種や日付は残したまま、会社名だけを伏せるのがポイントです。
IRで目指すべきは「AIに好かれるIR」ではなく「AIに正しく読まれるIR」
AIに好意的に評価されることを目指す前に、まず、自社が公表した事実をAIが出典に沿って理解できているかを確かめたい、と思った方も多いのではないでしょうか?
IR(開示)は、出した時点で終わりではありません。それがAIを通じて投資家にどう届くのか。開示後の「伝わり方」まで目を向けることが、これからのIRの新しい仕事になっていくはずです。
自社の「AIからの見え方」を確かめたい方へ
この実験は、私が個人でも進めている研究です。一方、株式会社シュタインズでは、IR BASEを通じて、公開IRサイトがAIに読み取れる形になっているかを可視化し、改善を支援しています。
なお、IR BASEのスコアは開示の読み取りやすさを見るもので、今回のAI投資判断の結果や、株価への効果を示すものではありません。
企業が伝えたつもりの姿と、AIが読み取った姿にずれはないか。まずはIR BASEで自社のスコアをご確認ください。開示の改善については、シュタインズのIR支援サービスでもご相談を受け付けています。
実験について:銘柄の選び方、事前に記録した仮説、データ上の制約は、GitHubで公開している検証手順書に記載しています。本文の数値は、手元に保存した結果ファイルから再集計したものです。個別のAI回答と結果ファイルは公開していません。本記事は過去データによる個人としての考察であり、個別銘柄の推奨や投資助言ではありません。
筆者:齊藤大将|株式会社シュタインズ 代表取締役