「AI時代のIR」と聞くと、生成AI向けの特別なページや新しいフォーマットを用意しなければならない、と考えがちです。しかし実際に多くのIRサイトを機械的に読み取ってみると、まず問題になるのはもっと地味で、基本的なところです。
今回取り上げるのは、IRライブラリのPDFリンクに「資料名」が入っていないというケースです。人がブラウザで見る分にはまったく問題がないため、社内でも制作会社でも気付かれにくいのが特徴です👇(当社には申し訳ないですが、見つけました……)

そしてこの小さな問題をたどっていくと、アクセシビリティ、SEO、AI対応という、普段は別々に語られるテーマが、実は一本の線でつながっていることが見えてきます。
この記事の要点
- カード型のIR資料一覧で、空のリンクをカード全体に重ねる作りがよく使われている
- 人には問題ないが、機械から見ると「どの資料名が、どのPDFを指しているか」が分からない
- この一つの欠陥が、アクセシビリティ・SEO・AI検索・RAG・AIエージェントで、それぞれ別の問題として現れる
- 根っこは同じ「意味の構造がHTMLに埋め込まれているか」。だから、見た目を一切変えずに資料名をリンクの中に入れるだけで、すべてが同時に改善する
人には見えているのに、機械には見えていない
ある上場企業のIRライブラリを例にします。画面上は、次のようなカードが並んでいます。
https://www.sansei-l.co.jp/ir/irlibrary/info01/
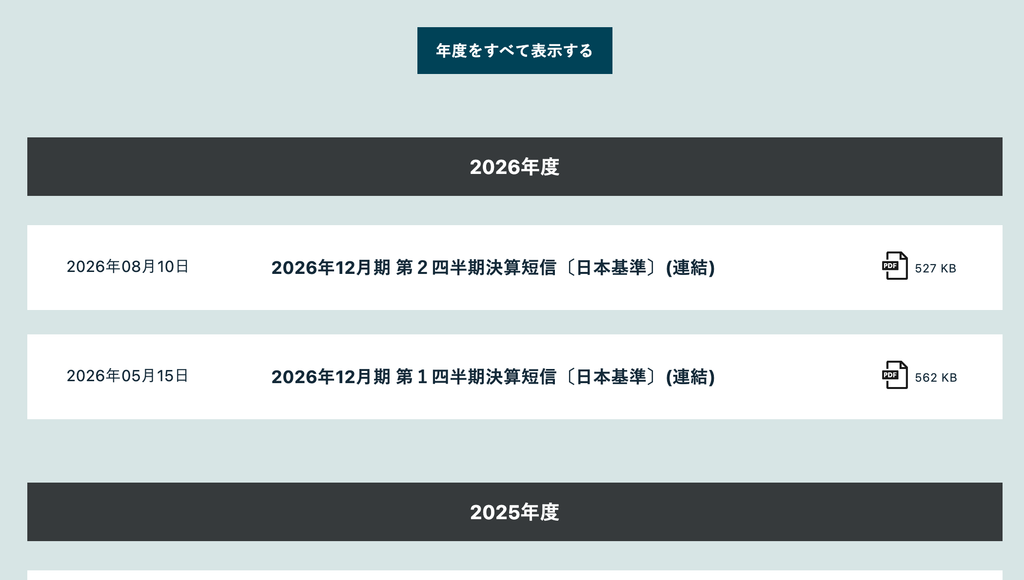
人間はこの画面を見て、
「2026年12月期 第2四半期決算短信」→ このカードを押す → PDFが開く
と自然に理解できます。カードのどこをクリックしてもPDFが開き、日付も資料名もサイズも一目で分かる。人間の利用者にとっては、使いやすいページです。
ところが、HTML(ページの裏側の構造)を見ると、簡略化して次のような作りになっています。
<div class="box">
  <a class="box-link" href="/ir/pdf/xxxx.pdf"></a>  <!-- 👈 中身が空のリンク -->
  <p class="date">2026年08月10日</p>
  <p class="title">2026年12月期 第2四半期決算短信〔日本基準〕(連結)</p>
  <p class="pdf">527 KB</p>
</div>PDFへのリンク(<a>タグ)は存在しますが、その中身は空になっています。資料名はリンクの外に、ただの文章として置かれています。この空のリンクをCSSでカード全体に広げることで、「箱のどこを押してもPDFが開く」ようにしているわけです。
これはカード型デザインで広く使われている手法で、見た目と操作には何の問題もありません。問題は、機械がこのページをどう読むかです。
Webでは、リンクの意味は原則としてリンクの中の文字(アンカーテキスト)で伝わります。人間は画面の配置から「この資料名のカードだから、このPDFは決算短信だろう」と判断できますが、機械にとって最も確かな手がかりは、リンクそのものに含まれる情報です。
| 人間に見えているもの | 機械がリンクから受け取れるもの | |
|---|---|---|
| 資料名 | 2026年12月期 第2四半期決算短信 | (なし) |
| リンク先 | クリックするとPDFが開く | /ir/pdf/xxxx.pdf |
| 両者の対応 | 配置から明らか | はっきりしない |
つまり、「資料名はページ上にある」「PDFのURLもある」、しかし「両者の対応関係」が明示されていない。これがこの問題の本質です。
一つの欠陥が、用途ごとに違う問題として現れる
「資料名とリンクの関係が明示されていない」という一つの欠陥は、それを読む側の用途によって、まったく別の問題に見えます。
Webアクセシビリティ:何のリンクか分からない
視覚障害のある方などが使う読み上げソフトでは、リンクの名前として資料名が読まれず、「リンク」とだけ、あるいはURLやファイル名が読み上げられることがあります。Webアクセシビリティの国際的な指針であるWCAGでも、リンクの目的が、リンクの文字や、プログラム上関連付けられた文脈から分かることが求められています(達成基準2.4.4)。
IRサイトは、あらゆる投資家に公平に情報を届けるための窓口です。アクセシビリティは「おまけ」ではなく、フェア・ディスクロージャーの延長にある論点だと言えます。
SEO:リンク先が何の資料か判断する手がかりが減る
Googleは公式ドキュメントで、リンク先の内容が分かるアンカーテキストを使うよう推奨しており、中身が空のリンクを悪い例として挙げています。「決算短信」「決算説明資料」といった資料名で検索されたときに、自社の一次資料が正しく見つかるかどうかに関わります。
AI検索:決算短信のPDFとURLを対応付けにくい
生成AIの検索機能は、ページを機械的に読み取って「このURLのPDFは、この決算短信である」と把握しようとします。リンクの中に資料名がなければ、その対応付けは周辺の文字からの推測に頼ることになります。
推測には誤りがつきものです。隣のカードの資料名と取り違えられる、日付やサイズの文字列を資料名と誤認される、といったことも起こり得ます。仕組みによって処理は異なりますが、少なくとも確かな手がかりが1つ減るのは間違いありません。
RAG:「タイトル ↔ 文書URL」の関係が崩れる
RAG(Retrieval-Augmented Generation)は、Web上や社内の文書を収集・分割して蓄積し、質問に応じて関連する文書を探してAIに回答させる仕組みです。金融情報サービスや、機関投資家・アナリストの社内ツールでも使われ始めています。
収集の段階で「タイトル ↔ 文書URL」の関係が正しく取れていないと、蓄積されたデータには「名前の分からないPDF」や「誤ったタイトルが付いたPDF」が混ざります。その結果、「○○社の第2四半期決算短信」を探しても見つからない、別の資料が返ってくる、といった形で検索結果の品質が落ちます。
AIエージェント:どのリンクを押せばいいか分からない
AIエージェントは、人間に代わってWebページを操作し、タスクをこなすAIです。「第2四半期決算短信を開いて要約して」と指示されたとき、エージェントはページ上のリンクの中から該当するものを選んでクリックする必要があります。
リンク自体に名前がなければ、どのリンクをクリックすべきか判断しにくくなります。画面の見た目から推測できるエージェントもありますが、ここでも確実性は下がります。
根っこは同じ:「意味の構造がHTMLに埋め込まれているか」
5つの問題は、技術も用途もばらばらに見えます。しかし根っこは同じです。
人間が見れば分かる意味関係を、機械にも分かる形で渡せているか。
アクセシビリティもSEOもAI対応も、この同じ問いを、別の用途から見ているにすぎません。
だからこそ、今回のケースでは次のようにするだけで、
<a href="/ir/pdf/xxxx.pdf">
  2026年12月期 第2四半期決算短信〔日本基準〕(連結)
</a>複数の層が同時に改善します。
| 用途 | 改善されること |
|---|---|
| アクセシビリティ | 読み上げソフトが資料名を読み上げる |
| SEO | 検索エンジンがリンク先の資料を判断できる |
| AI検索 | AIクローラーが資料名とPDFのURLを対応付けられる |
| RAG | 蓄積データに正しい「タイトル ↔ 文書URL」が入る |
| AIエージェント | 指示された資料のリンクを確実に選べる |
興味深いのは、アクセシビリティのために正しく作ったHTMLが、そのままSEOにも効き、さらにAIにも読みやすくなるという点です。アクセシビリティ、SEO、AI対応は別々の施策ではなく、そのかなりの部分が「意味を機械に明示する」という共通の基盤の上に成り立っています。
SEOの先へ:AIは「理解」から「行動」まで進む
RAGとAIエージェントまで視野に入れると、この問題はさらに一段重要になります。
従来のSEOが目指していたのは、ざっくり言えば「検索エンジンに理解してもらう」ところまででした。AI時代には、その先が続きます。
理解してもらう → 正しく取得してもらう → 検索対象として使ってもらう → AIがその情報を使って行動する
たとえば将来、投資家がAIエージェントにこう頼むとします。
「この会社の直近3年の決算短信を集めて、営業利益率の推移を出して」
このときAIは、おおよそ次の処理を順番に行います。
IRページを探す
  ↓
決算短信を特定する
  ↓
正しいPDFのURLを選ぶ
  ↓
PDFを取得する
  ↓
内容を読む
  ↓
数字を抽出する最初の「決算短信を特定する」「正しいPDFのURLを選ぶ」の段階でHTMLの意味構造が弱いと、その後の工程すべてに影響が及びます。違う四半期の資料を拾えば数字は誤り、取りこぼせば推移が欠ける。どれだけ優秀なAIでも、入口で取り違えた資料からは正しい分析は出てきません。
つまり、空のリンクという一見小さなHTMLの話は、実際には
「その企業の情報が、AIの情報流通網に正しく乗るかどうか」
という話につながっています。
Webに求められてきたものを振り返ると、次のような進化として整理できます。
| 時代 | 求められるWeb |
|---|---|
| かつて | 人に見やすいWeb |
| SEO時代 | 検索エンジンにも分かるWeb |
| AI時代 | 機械が理解し、取得し、再利用し、行動できるWeb |
今回の空のリンクは、まさに「人には見えているけれど、機械には意味がつながっていない」箇所です。AI時代のIRサイトを考えるうえで、核心にかなり近いところにある問題だと言えます。
改善方法:見た目はそのまま、資料名をリンクの中へ
この問題は、デザインを一切変えずに直せます。
推奨:資料名をリンクの中に入れ、クリック範囲はCSSで広げる
<div class="box">
  <p class="date"><time datetime="2026-08-10">2026年08月10日</time></p>
  <p class="title">
    <a class="stretched-link" href="/ir/pdf/xxxx.pdf">
      2026年12月期 第2四半期決算短信〔日本基準〕(連結)
    </a>
  </p>
  <p class="pdf">PDF 527 KB</p>
</div>
/* カード全体を基準位置にする */
.box {
position: relative;
}
/* リンクの見えない領域をカード全体に広げる */
.box .stretched-link::after {
content: "";
position: absolute;
inset: 0;
}リンクの中に資料名が入ったことで、読み上げソフトも検索エンジンもAIも、「このPDFは2026年12月期 第2四半期決算短信である」とリンク単体から理解できます。一方、CSSの疑似要素でクリック範囲をカード全体に広げているため、利用者の操作感は今とまったく同じです。
あわせて、日付を<time>要素で囲んで機械が読める形式(2026-08-10)を添えておくと、「いつの資料か」もより確実に伝わります。先ほどの「直近3年の決算短信を集める」ような処理では、この日付情報も重要な手がかりになります。
どうしても今の構造を変えられない場合
CMSやテンプレートの制約で大きな修正が難しい場合は、次の順で検討してください。
- 資料名そのものを
<a>の中に入れる(上記の推奨案。最も確実) - 画面上の資料名に
idを付け、リンク側からaria-labelledbyで参照する - 最低限、リンクに
aria-label="2026年12月期 第2四半期決算短信(PDF)"を付ける - いずれの場合も、中身が空のリンクのまま放置しない
2の例は次のとおりです。画面上の資料名をそのままリンクの名前として使うため、資料名を二重管理する必要がありません。
<div class="box">
  <a class="box-link" href="/ir/pdf/xxxx.pdf" aria-labelledby="doc-20260810"></a>
  <p class="date">2026年08月10日</p>
  <p class="title" id="doc-20260810">2026年12月期 第2四半期決算短信〔日本基準〕(連結)</p>
  <p class="pdf">527 KB</p>
</div>なお、aria-labelやaria-labelledbyは、読み上げソフト向けの対策としては明確に有効です(W3CがWCAGの達成方法として示しています)。ただし、検索エンジンやAIクローラーがこれらをアンカーテキストと同じように扱うとは限りません。アクセシビリティだけでなく、SEO・AI検索・RAG・AIエージェントまでまとめて改善するなら、やはり1の「資料名をリンクの中に入れる」が最も確実です。
自社サイトで確認する方法
専門的な知識がなくても、次の方法でおおよその状況を確認できます。
1. Lighthouseで診断する
Google ChromeでIRライブラリのページを開き、右クリック →「検証」→「Lighthouse」タブ →「ユーザー補助(Accessibility)」にチェックを入れて分析します。結果に「リンクに識別可能な名前が付いていません」という指摘が出た場合、空のリンクが含まれている可能性が高いです。
2. リンクの「名前」を直接確認する
同じく「検証」画面で、資料カードのリンク部分を選択し、右側の「ユーザー補助(Accessibility)」ペインを開きます。「Name(名前)」欄が空、またはURLだけになっていれば、機械にはそのリンクの意味が伝わっていません。
3. 読み上げソフトで聞いてみる
MacならVoiceOver、WindowsならナレーターやNVDAで、IRライブラリのリンクを順に移動してみてください。資料名ではなく「リンク」とだけ読まれる場合は、改善の余地があります。
読み上げソフトで意味が伝わらないリンクは、ほぼ確実にAIにとっても分かりにくいリンクです。アクセシビリティのチェックは、そのままAI可読性の簡易チェックとしても使えます。
制作会社への依頼文の例
社内で修正できない場合は、次のように依頼するとスムーズです。
IRライブラリの資料一覧について、PDFへのリンク(
<a>要素)の中に資料名のテキストが入るよう修正をお願いします。 現在はカード全体に中身の空のリンクが重ねられており、読み上げソフト・検索エンジン・AIクローラーからリンク先の資料名が判別できない状態です。 見た目とクリック範囲は現状のまま維持したいため、資料名をリンクテキストにしたうえで、CSSの疑似要素(::after)でクリック範囲をカード全体に広げる方法をご検討ください。 構造上難しい場合は、aria-labelledbyで画面上の資料名とリンクを関連付ける方法でも構いません。
まとめ:「AI対応」は、特別なことではない
今回の例から分かるのは、AI時代のIRサイトとは、AI向けの特殊なページを作ることではないということです。
人間が画面を見て自然に理解している意味の関係を、HTMLの上でも明示する。
- 見出しは見出しタグ(
h1〜h3)で - 表は
tableで - 資料名はリンクの文字として
- 日付は日付として
- 画像には代替テキスト(
alt)を - 関連する情報は、構造の上でも関連付けて
いずれも昔からあるWeb標準・アクセシビリティ・SEOの基本です。そして、こうした「当たり前の良い作り」が、そのまま検索エンジンにも、AI検索にも、RAGにも、AIエージェントにも効きます。アクセシビリティ、SEO、AI対応は、別々の予算で別々に取り組む施策ではなく、「意味を機械に明示する」という一つの基盤への投資です。
「AI対応」という言葉は抽象的になりがちですが、実際の改善点はこのように具体的で、多くの場合は小さな修正で済みます。まずは自社のIRライブラリで、決算短信のPDFリンクに資料名が入っているかを確かめてみてください。それは、自社の決算情報がAIの情報流通網に正しく乗るかどうかを確かめることでもあります。
IR BASEの診断について
IR BASEでは、東証上場企業のIRサイトを機械可読性の観点から診断しています。診断項目には、「こちら」「詳細」のような曖昧なリンク文字の割合が含まれており、今回のような中身が空のリンクや、PDFのURLと資料名を機械的に対応付けられる割合についても、同様に測定できるよう検討を進めています。
一方で、こうした作りのサイトは数多く存在するため、IR BASEのクローラー自体も、カードや親要素など近くの文字から資料名を復元する処理を備えるべきだと考えています。サイト側には改善を提案し、読み取る側は実際のAIに近い形で補う――この両面から、AI時代のIR情報の届き方を可視化していきます。
自社IRサイトの診断にご関心のある方は、お気軽にお問い合わせください。