最初にポイントを。
- LLM(大規模言語モデル)に日本株の決算を読ませる実験で、企業が開示していた負債関連の数字が、データ提供の段階で抜け落ちていました
- AIはその空欄を「開示されていない」と解釈し、弱気判断38件のうち37件(97%)がこれを理由に挙げていました
- 数字を補うと、この理由は0件になり、毎週の判断の15%が強気寄りに変わりました
- IR室にできるのは「開示を増やす」ことよりも、開示がデータとして落ちずに届く形に整えることです
本記事は研究用の過去データを用いた実験の報告で、投資助言ではありません。特定企業の評価を示すものでもありません。実験条件と限界は後半にまとめています。
前回の続きです。
決算を読むのは、人だけではなくなった
生成AIに決算を要約させる、複数社の財務を比較させる、といった使い方は、機関投資家から個人投資家まで広がりつつあります。さらに、LLMに決算の数字を読ませ、著名投資家の考え方で「買い/様子見/売り」を判断させる仕組みも、オープンソースで誰でも動かせるようになりました。
ここでIR担当者が押さえておきたいのは、AIが読んでいるのは多くの場合、開示書類そのものではなく「データ化された開示」だという点です。企業が正しく開示していても、データになる過程で一部が落ちれば、AIにとってその数字は存在しません。
株式会社シュタインズでは、この仕組みを日本株向けに改造して検証する中で、まさにこの現象を確認しました。
実験の概要
オープンソースの「AIヘッジファンド」(virattt/ai-hedge-fund)を日本株向けに改造し、次の条件で動かしました。
| 項目 | 条件 |
|---|---|
| 対象 | 東証プライムの大型・中型株30社(規模別にルールで無作為抽出、金融業は除外) |
| 期間・頻度 | 2026年2〜6月、毎週1回 |
| 判断の形式 | 各社を「強気/中立/弱気」で判断 |
| 判断役 | ベンジャミン・グレアム風、ウォーレン・バフェット風の2つのAIエージェント |
| 財務データ | J-Quants API(日本取引所グループのデータサービス)無料プランの決算短信サマリー |
何が起きたか → 「データがない」が、弱気の理由になった
グレアム風のAIは、グレアムの投資哲学にならい、流動比率や負債の大きさといった財務の安全性を重視するよう設計されています。
ところが、J-Quants無料プランのデータには、流動資産・流動負債・借入金の項目がありませんでした。その結果、グレアム風AIの弱気判断38件のうち37件(97%)が「負債のデータがない」ことを理由に挙げていました。
判断理由には、たとえば次のような記述がありました(原文は英語、訳は筆者)。
- 「提出書類には、流動比率も負債資本比率もない」
- 「流動比率と負債資本比率がないので、財務の強さを確かめられない。見えない財務に上乗せの価格は払わない」
- 「総合商社なのに流動比率も負債の数字もない。おそらく借入は多いのだろう」
注目すべきは3つ目です。AIは空欄の理由を知らされていないため、「借入は多いのだろう」と、根拠のない推測で空欄を埋めています。例えば、ある総合商社について、Graham 役のAIはこう書いていました。
“no current ratio or debt figures are given for a trading house that is presumably heavily leveraged”(総合商社なのに流動比率も負債の数字もない。おそらく借入は多いのだろう)
空欄を「不明」のまま置くのではなく、業種から悪い方の値を推測して判断に使っています。会社名や業種を渡している場合、LLM の一般知識が空欄を埋める材料になります。
一方、流動資産・流動負債・借入金は、事業会社であれば通常、決算短信の貸借対照表で開示されています。つまり、
欠けていたのは企業の開示ではなく、データ提供側の収録項目でした。
数字を1つ補うと、判断が変わった
無料プランにも、総資産と純資産はあります。そこで私独自に「総資産 − 純資産」から負債合計を求め、負債合計 ÷ 自己資本(いわゆるD/Eレシオの簡易版)を計算してAIに渡し、同じ30社・同じ期間で再実行しました。
なお、この比率は有利子負債ではなく負債合計ベースであり、グレアムが見る指標の代替にすぎません。それでも結果は明確でした。
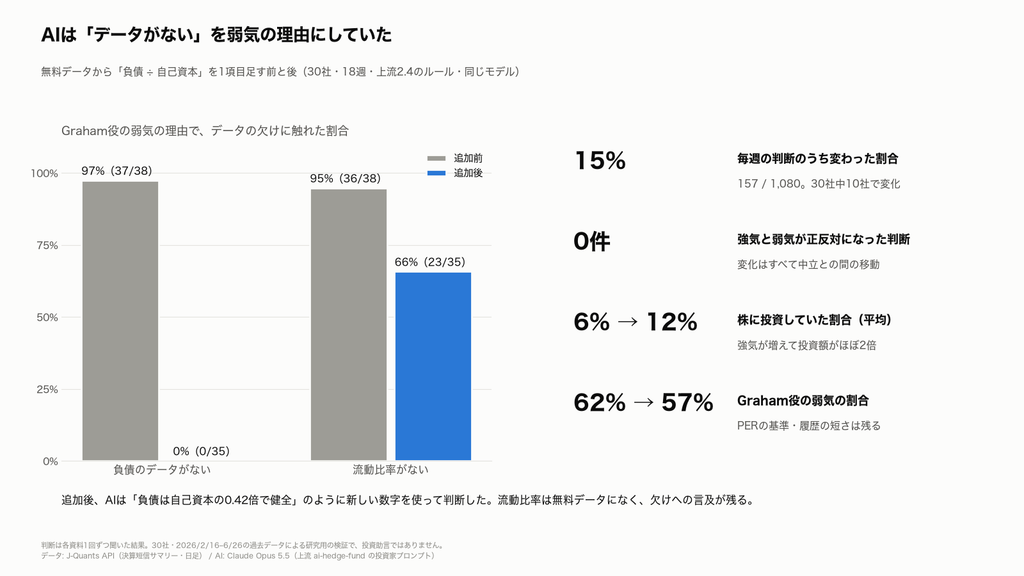
- 「負債のデータがない」という理由は、37件 → 0件
- AIは「負債は自己資本の0.42倍で健全」「負債が0.32倍から0.48倍に増えた」のように、数字に基づいて判断するようになった
- 毎週の判断の15%が変化し、その向きは強気寄り(「弱気→中立」「中立→強気」)
- 流動比率は無料データからは作れないため、その欠けへの言及は残った
AIは「悪い数字」だけでなく、「見えない数字」に対しても慎重になる。データが1つ補われるだけで、その慎重さの一部が解けたことになります。
なぜ起きるのか:開示からAIまでの4段階
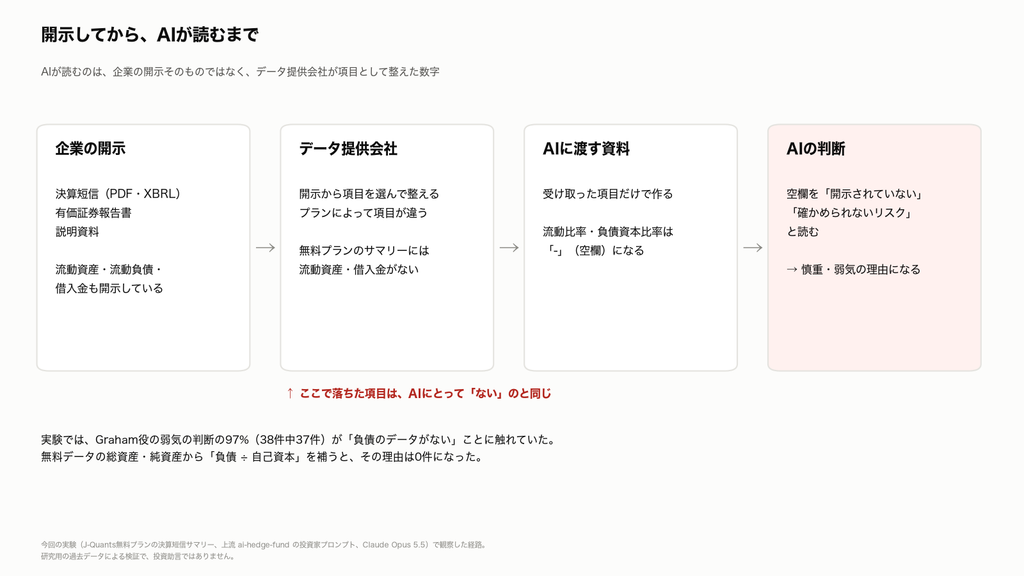
- 企業が決算短信・有価証券報告書・決算説明資料を開示する
- データ提供会社が、その中から項目を選んで数値を整える(プランや商品によって収録項目が異なる)
- AIツールが、受け取った項目だけで分析用の資料を組み立てる
- AIが、資料にない項目を「ない」ものとして判断する
問題の核心は、空欄には少なくとも3つの意味があるのに、AIには区別がつかないことです。
| 空欄の意味 | 例 |
|---|---|
| データ源に収録されていない | 今回の流動資産・流動負債・借入金 |
| 企業が開示していない | 業績予想の非開示など |
| そもそも該当しない | 無借金企業の借入金など |
この区別が伝わらないと、AIは「企業が開示していない」「悪い数字だから出していないのだろう」と、もっともらしい説明を自ら補ってしまいます。企業の側からは見えないところで、事実と異なる説明が生まれうるということです。
IR室・経営企画室にできる5つのこと
今回の欠けは企業の開示不足によるものではないため、「開示を増やせば解決する」とは言えません。ただし、開示がデータとしてAIに届くまでの経路で落ちにくくすることは、企業側にもできます。根拠の強さを分けて整理します。
① 決算短信のサマリー(1枚目)を、漏れなく正確に
今回AIに届いたのは、決算短信のサマリー情報にあたる項目でした。補った「負債 ÷ 自己資本」も、サマリーの総資産・純資産・自己資本から作れました。サマリー情報は様式が定型化されており、多くのデータ提供の入口になる部分です。業績予想を開示しない場合などは、その旨と理由を明記しておくと、空欄の誤解を防げます。
根拠の強さ:実験で確認
② XBRLでは、主要な数値に標準の項目(標準タクソノミ)を使う
J-Quantsの財務諸表API(有料プラン)は、仕様書で「会社独自の拡張項目は含まない」と明記しています。標準タクソノミに該当する科目があるにもかかわらず独自の拡張科目でタグ付けすると、その数値はデータ提供の段階で落ちる可能性があります。開示支援会社や監査法人とタグ付けの方針を一度確認しておく価値があります。
根拠の強さ:仕様書で確認。影響の大きさは未測定
③ 一時的な損益や、過去数値の組み替えを「数字で」説明する
事業を分離した1社について、AIは「本業は堅調なのに純利益が崩れた。原因は資料からは分からない」と判断を保留しました。サマリーには組み替え後の前年数値がないためです。非継続事業、遡及修正、セグメント変更などがある期は、組み替え後の比較数値を、画像ではなくテキストの表で示すことが有効です。
根拠の強さ:実験で観察(1社)
④ 期限内でも、決算発表はなるべく早く
過去時点で分析する場合、「その日までに開示された情報だけ」を使うのが原則です(ポイント・イン・タイム)。基準日を2月9日にした銘柄選定では、45日ルールの目安(2月14日ごろ)内に発表した企業のうち14社が「決算が足りない」として分析対象から外れました。期限を守っていても、発表が遅いほど「最新の決算がない企業」として扱われる時間が長くなります。
根拠の強さ:実験で観察(銘柄選定の段階)
⑤ 主要な数値を、説明資料(PDF)だけに載せない
今回の仕組みは構造化された数値だけを読み、決算説明資料は読みませんでした。多くのAIツールも、まず構造化データから読むと考えられます。KPIや調整後利益など重要な数値は、PDFに加えてExcelやHTMLの表でも提供しておくのが安全です(pdfを全く読まないというわけではありません)。
根拠の強さ:一般的な仕組みからの推論。今回は未検証
| できること | 根拠の強さ |
|---|---|
| ① 決算短信サマリーの数値を漏れなく正確に | 実験で確認 |
| ② XBRLで主要数値に標準の項目を使う | 仕様書で確認(影響は未測定) |
| ③ 一時的損益・組み替えを数字で説明 | 実験で観察(1社) |
| ④ 期限内でも決算発表を早めに | 実験で観察(銘柄選定段階) |
| ⑤ 主要数値をPDFだけに載せない | 推論(未検証) |
「AIに好かれる開示」ではなく「機械が正しく読める開示」
ここで挙げた対策は、AIに有利な見え方を演出するためのものではありません。定型部分を正確に埋める、標準の項目を使う、一時的な要因を数字で説明する。いずれも、人の投資家やアナリストにとっても誤解を減らす取り組みです。
機械が正しく読めることは、開示が正しく伝わることの一部だと、私たちは考えています。
経営企画室の視点では、開示の品質管理を「提出して終わり」から「受け手に正しく届くまで」に広げる、という捉え方ができます。たとえば年に一度、自社の銘柄について主要なAIツールがどう説明するかを確認するだけでも、思わぬ欠けや誤解に気づくきっかけになります。
この実験から言えないこと
- AIの判断が、実際の株価や売買にどれだけ影響しているかは、今回の実験では分かりません
- 結果は、1つのAIモデル、2つの判断役、30社、約4か月半、無料データの範囲のものです。別のモデル・判断役・有料データでは変わりえます
- 今回の欠けはデータ提供側の項目によるもので、「開示の少ない企業がAIに弱気に評価される」ことを直接示したものではありません
- AIの判断は同じ資料でも揺れることがあります。今回の数字は各資料1回ずつの判断です
データ提供側・AI開発側への期待
この問題は、IR室だけで解決できるものではありません。
- データ提供側へ:無料・低価格のプランでも、流動資産・流動負債・有利子負債のような主要な財務項目が揃っていれば、AI分析の偏りは減ると考えられます
- AIツールの開発側へ:空欄の意味(データ源にない/企業が開示していない/該当しない)をAIに伝えなければ、AIは「開示されていない」と誤って説明します
IR室向けチェックリスト
- 決算短信のサマリー(1枚目)の数値に、空欄や誤りがない
- 空欄にする項目(業績予想など)は、その理由を明記している
- XBRLで、標準タクソノミに該当する主要数値に独自の拡張科目を使っていない
- 一時的な損益や過去数値の組み替えを、テキストの表で数字として説明している
- 主要な財務数値やKPIが、説明資料(PDF)だけに載っていない
- 決算の発表日が、期限ぎりぎりに偏っていない
- 自社の数値がAIツールでどう説明されるかを、定期的に確認している
実験の詳細・関連記事
実験のコードと手順は TIshow/ai-hedge-fund-jp で公開しています。エンジニア向けの詳しい解説は、別記事「AIアナリストは『データがない』を弱気の理由にする」にまとめています。
同じ実験から見えた別の傾向は、AIは有名銘柄に甘い?日本株AIトレーディングで見えた「弱気を控える」傾向で解説しています。IRサイト全体の機械可読性については、貴社のIRは、AIに何点で読まれているかもあわせてご覧ください。
貴社のIRは、AIにどう読まれていますか?
IR BASEでは、上場企業のIRがAIにどれだけ正しく読み取れるかをスコア化しています。銘柄コードと会社メールアドレスだけで、自社のスコアを無料で確認できます。開示の改善や発信体制づくりのご相談は、IR支援サービスまたはお問い合わせからどうぞ。